사용자를 읽는 방법이 바뀌고 있다 — 데이터와 AI로 확장되는 UX 리서치
최승환 마크로밀엠브레인 상무이사
2026년 9월 16일 한국디자인진흥원 AX사업실 초청으로 마크로밀엠브레인 최승환 상무가 발표하고 토론을 나누었던 내용을 바탕으로, 실제 기업에서 새롭게 시도되고 있는 새로운 사용자조사 방법이 어떻게 변화를 맞이하고 있는지 살펴본다. 전체 내용은 주제별로 총 3편으로 구성하였다. 1편에서는 사용자에게 묻는 조사에서 행동을 읽는 조사로의 변화, 2편에서는 AI가 사람의 행동 속에서 우리가 미처 발견하지 못했던 니즈를 찾아내는 방법, 3편에서는 다시 첫 질문으로 돌아가 합성사용자가 실제 사용자를 대신할 수 있는가를 다룬다. 1편은 ‘변화’, 2편은 ‘발견’, 3편은 ‘대체 가능성에 대한 판단’이다.
1편 사용자에게 묻는 시대에서, 행동을 읽는 시대로
설문과 인터뷰를 넘어 구매기록, 화면, 영상에서 실제 사용자를 이해하는 방법
1편은 시리즈 전체의 변화부터 보여준다. Response Data → Behavior Data → Real Human Data의 흐름과 함께 영수증 데이터, 스마트폰 홈화면, 실제 기능 사용영상 등을 사례로 제시하면 된다. 사용자가 말한 것과 실제로 한 것 사이의 차이가 출발점이다.
2편 AI는 우리가 보지 못했던 사용자를 발견할 수 있을까
행동과 인식의 차이에서 잠재 니즈를 찾아내는 새로운 사용자조사
핵심은 AI 자체가 아니라 사람이 일일이 보기 어려웠던 행동을 AI가 읽을 수 있게 됐다는 점이다. 생활영상 분석, 행동×인식 비교, AI 글래스의 ‘멈칫하는 행동’, 검색데이터의 니즈 변환, 이미지에 맥락을 붙이는 방법 등을 묶는다. 특히 “사용자는 불편을 겪으면서도 그것을 불편이라고 인식하지 않을 수 있다”는 점이 중심 메시지가 된다.
3편 AI는 사용자를 대신할 수 있을까
합성 소비자의 가능성과 한계, 그리고 AI로 발견하고 사람으로 검증하는 리서치
합성 소비자를 실제 소비자와 비교한 사례를 중심으로 한다. AI가 빠르게 문제와 가설을 찾는 데는 유용하지만 최신 행동, 감성, 중요도와 우선순위까지 그대로 믿기는 어렵다는 점을 보여준다. 마지막은 “발견과 검증은 다르다. AI로 발견하고, 사람으로 검증한다.”로 끝내면 시리즈 전체가 정리된다. 세 제목의 구조도 의도적으로 다르게 잡았다.
최승환
㈜마크로밀엠브레인 상무이사. 약 25년간 신제품 개발(NCD), UX·UI, 디자인 리서치, 정성조사와 에스노그래피 분야에서 활동해온 UX 리서치 전문가다.
삼성전자 Account Manager로 다양한 신제품 및 UX 리서치 프로젝트를 수행해왔다.
홍익대학교 산업디자인학 석사.
2026년 4월 산업단지정책해커톤에 서비스디자이너·퍼실리테이터로 참여했으며, 그가 참여한 ‘붕어빵’ 팀의 ‘온통(On-通)이음 정류장’이 최고상인 산업통상부장관상을 수상했다.
① 사용자에게 묻는 시대에서, 행동을 읽는 시대로
User Data를 넘어 ‘Real Human Data’로
-> 발표자료 보기
2026년 엔비디아는 한국의 실제 인구 분포를 반영한 대규모 합성 페르소나 데이터셋 Nemotron Personas를 공개했다. 나이, 성별, 직업, 교육 수준, 거주지역과 같은 인구통계적 특성뿐 아니라 관심사와 성격 등을 조합해 실제 한국 사회의 분포를 닮은 가상의 사람들을 만들어낸 데이터다.[1] 이런 합성 페르소나를 AI와 결합하면 가상의 소비자에게 제품이나 서비스에 대한 반응을 묻고 다양한 상황을 시뮬레이션하는 것도 가능해진다.
그렇다면 실제 사용자를 만나지 않고도 사람을 이해할 수 있는 시대가 오는 것일까?
오히려 이런 변화 때문에 반대의 질문이 중요해지고 있다. AI가 인간을 이해하고, 인간에게 맞는 판단과 추천을 하려면 과연 어떤 데이터를 학습해야 할까?
Consumer와 User를 넘어 Human으로
우리는 오랫동안 사람을 Consumer 또는 User라는 이름으로 바라봐 왔다. 마케팅에서 사람은 상품을 선택하고 구매하는 Consumer였고, 디지털 서비스에서 사람은 앱과 웹을 이용하는 User였다. 그래서 기업이 축적해 온 데이터 역시 무엇을 구매했는지, 어떤 화면을 클릭했는지, 어떤 서비스에서 이탈했는지와 같은 구매와 이용의 기록이 중심이었다.
그런데 AI가 서비스의 중심으로 들어오면서 질문이 조금 달라지고 있다.
클릭, 구매, 검색 기록만 충분할까? 아니면 그 행동 뒤에 있는 의도와 감정, 상황과 생활환경까지 알아야 할까?
이 질문에서 최승환 엠브레인 상무는 ‘Real Human Data’라는 개념을 생각하게 되었다.
‘Human’이라는 표현을 쓰는 데에는 이유가 있다. Consumer는 기업과 시장의 관점에서 바라본 인간이고, User는 제품과 서비스의 관점에서 바라본 인간이다. 반면 AI의 관점에서 인간은 특정 제품을 구매하거나 특정 서비스를 사용하는 순간에만 존재하지 않는다. 사람은 생각하고, 망설이고, 감정을 느낀다. 같은 행동도 서로 다른 이유로 할 수 있으며, 같은 사람도 시간과 장소, 함께 있는 사람과 주변 환경에 따라 다르게 행동한다. 따라서 AI가 인간을 학습한다는 것은 단순히 ‘무엇을 구매했는가’ 또는 ‘무엇을 클릭했는가’를 학습하는 것보다 훨씬 넓은 문제가 된다. 그 사람의 의도, 니즈, 감정, 판단, 그리고 행동이 발생한 실제 상황까지 알아야 한다.
여기서 Human Data라는 개념의 필요성이 생긴다.
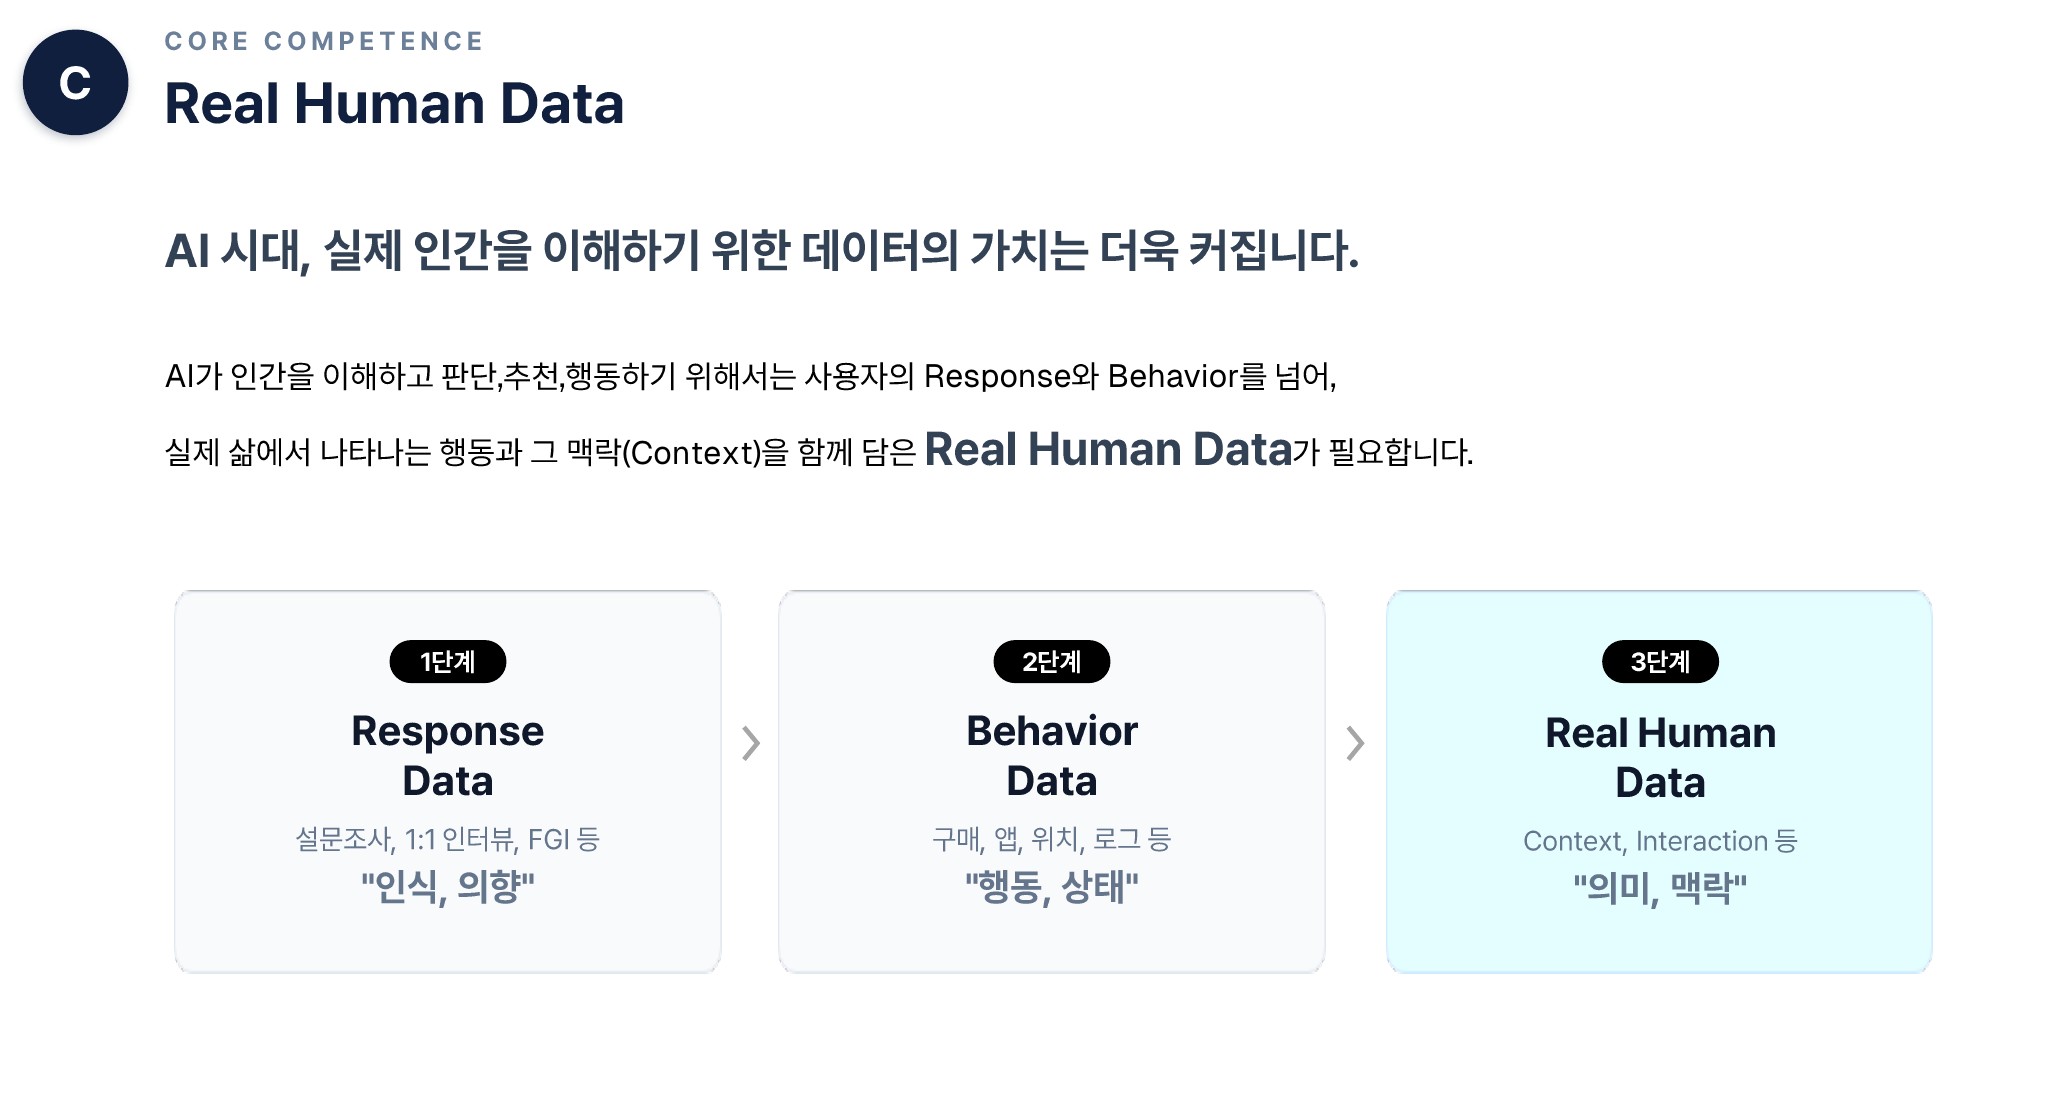
Real Human Data란 무엇인가
Real Human Data는 아직 학계에서 합의된 하나의 표준 용어라기보다, AI 시대의 사용자 데이터를 새롭게 바라보기 위해 제안하는 실무적 개념 프레임에 가깝다.
최승환 상무는 이를 다음과 같이 정의한다. Real Human Data란 실제 인간의 응답과 행동을 기반으로, 그 행동이 가진 ‘의미(Meaning)’와 행동이 발생한 ‘맥락(Context)’까지 함께 담은 데이터다.
기존의 데이터가 주로 두 가지 질문에 답했다면,
“무엇이라고 말했는가?”
“무엇을 했는가?”
Real Human Data는 여기에 두 가지 질문을 더한다.
“왜 그렇게 했는가?”
“어떤 상황에서 그렇게 했는가?”
이를 간단하게 표현하면 다음과같다.
Real Human Data = Response / Behavior + Meaning + Context
전통적인 사용자조사가 주로 사람의 응답(Response)을 통해 사용자를 이해했다면, 최근에는 구매기록, 클릭로그, 위치, 이미지, 영상 등 실제 행동(Behavior)을 직접 볼 수 있는 데이터가 훨씬 많아졌다. 그러나 행동을 볼 수 있게 됐다고 해서 곧바로 사람을 이해하게 되는 것은 아니다.
행동 뒤의 ‘의미’를 담는 데이터
첫 번째 요소는 Meaning이다.
예를 들어 한 사용자가 쇼핑 앱에서 여러 상품을 반복해서 비교했다고 하자.
로그 데이터에서는 ‘상품 A → 상품 B → 상품 A → 상품 C’라는 이동을 확인할 수 있다. 하지만 이 행동만으로는 이유를 알 수 없다.
가격이 부담스러워서 비교했을 수도 있고, 상품 품질을 확신하지 못했을 수도 있다. 가족에게 보여주기 위해 여러 상품을 저장했을 수도 있고, 구매 의사는 없지만 단순히 정보를 탐색했을 수도 있다.
행동은 같지만 그 행동이 사람에게 갖는 의미는 전혀 다르다.
따라서 Meaning Data에는 행동 뒤에 존재하는 Intent, Need, Motivation, Emotion, Value, Evaluation이 함께 담겨야 한다.
이러한 생각은 HCI의 Activity Theory와 연결된다.
초기 HCI가 사람이 수행하는 Task 자체에 집중했다면, Activity Theory는 기술 사용을 더 넓은 인간 활동 속에서 보고 그 행동의 목적과 동기, 의미까지 이해해야 한다고 본다. HCI에서 이 이론은 기술 사용을 단순한 조작이 아니라 목적과 필요가 있는 인간 활동으로 확장해 바라보는 기반이 되어 왔다.
결국 Meaning Data가 묻는 질문은 간단하다.
“이 사람은 왜 이렇게 행동했을까?”
행동이 일어난 ‘맥락’을 담는 데이터
두 번째는 Context다.
몇 년 전 스마트 TV 관련 사용자조사를 진행하면서 흥미로운 경험을 한 적이 있다.
조사의 원래 목적은 사용자의 거실에 설치된 TV 화면을 촬영해 Smart Hub가 어떻게 구성되고 이용되는지 분석하는 것이었다.
그런데 고객이 정작 흥미롭게 본 것은 TV 화면만이 아니었다.
TV 옆에 Soundbar가 있는지, AI Speaker가 어디에 놓여 있는지, 셋톱박스와 게임기는 어떻게 연결되어 있는지, TV가 거실의 어느 위치에 설치되어 있고 주변 가구는 어떻게 배치되어 있는지에 관심을 보였다.
처음에는 분석 대상이 아니었던 ‘TV 주변의 것들’이 오히려 그 가정에서 TV가 실제로 어떻게 사용되고 있는지를 설명해 주고 있었던 것이다. 이것이 Context Data다.
사람의 행동은 진공상태에서 발생하지 않는다. 시간, 장소, 주변 사람, 물리적 환경, 사용하는 기기, 직전과 이후의 행동 속에서 일어난다.
Lucy Suchman의 Situated Action은 이러한 관점에 중요한 이론적 근거를 제공한다. 인간의 행동은 사전에 만들어진 계획만으로 설명할 수 없으며, 실제 행동이 일어나는 사회적·물리적 상황과의 관계 속에서 이해해야 한다는 것이다.
특히 행동의 의미는 관찰 가능한 행동 자체나 사전 의도 어느 한쪽에만 존재하는 것이 아니라 행동과 상황, 의도의 관계 속에서 만들어진다.
Edwin Hutchins의 Distributed Cognition 역시 인간의 인지가 개인의 머릿속에만 존재하는 것이 아니라 사람, 도구, 기술, 물리적 환경에 걸쳐 분산되어 있다고 본다.
우리가 인간의 행동을 제대로 이해하려면 그 사람이 놓인 사회적·물질적 환경도 함께 관찰해야 한다는 것이다.
따라서 앞서 언급한 TV 주변의 Soundbar와 AI Speaker는 분석에서 제거해야 할 ‘Noise’가 아니라, 경우에 따라서는 사용자의 실제 경험을 설명하는 Context가 될 수 있다.
어쩌면 오래전부터 있던 생각이다
사실 인간의 행동을 의미와 맥락 속에서 보아야 한다는 생각 자체는 새로운 것이 아니다.
인류학자 Clifford Geertz의 Thick Description 역시 인간 행동을 표면적으로 기록하는 데 그치지 않고, 그 행동이 어떤 문화적·사회적 맥락 속에서 어떤 의미를 갖는지를 함께 해석해야 한다는 문제의식에서 출발한다.
HCI에서도 인간을 단순한 정보처리 시스템이나 Task 수행자로 바라보는 관점에서 벗어나 인간의 동기, 의미, 문화, 사회적 관계와 실제 생활환경까지 연구 범위를 확장해 왔다.
Activity Theory와 Situated Action, Distributed Cognition은 이러한 흐름을 대표한다.
그렇다면 Real Human Data는 완전히 새로운 이론이라기보다, 이러한 오랜 인간 중심 연구의 전통을 AI 시대의 Data 관점에서 다시 정의하는 시도라고 보는 편이 적절하다.
그런데 왜 지금 Real Human Data인가
중요한 것은 지금 우리가 인간과 기술의 관계에서 새로운 변곡점을 지나고 있다는 점이다.
과거의 디지털 서비스에서는 인간이 시스템을 사용했다. 사용자가 검색어를 입력하고, 메뉴를 선택하고, 버튼을 눌렀다. 기업은 그 결과로 발생한 Click, Search, Purchase, Log 데이터를 분석하면 상당 부분 사용자의 행동을 이해할 수 있었다.
그러나 AI Agent가 등장하면서 관계가 달라지고 있다. 앞으로 AI는 단순히 사용자의 명령에 반응하는 것을 넘어 추천하고, 판단하고, 계획하고, 때로는 사용자를 대신해 행동하게 된다.
그렇다면 좋은 AI를 만들기 위해 필요한 Human Data 역시 달라질 가능성이 크다.
AI가 인간을 제대로 돕기 위해서는 단순히 과거에 무엇을 클릭했는지만 아는 것으로는 부족하다.
지금 무엇을 하려는가.
왜 그것을 원하는가.
어떤 상황에 있는가.
무엇을 불편해하는가.
어떤 결과를 기대하는가.
이러한 정보가 중요해진다.
Real Human Data는 어디에 쓰이게 될까
첫째는 AI Learning이다.
실제 인간의 행동과 선택뿐 아니라 그 행동의 의도와 맥락까지 학습함으로써 AI가 사람을 보다 정교하게 이해하도록 할 수 있다.
둘째는 AI Validation이다.
AI Agent가 실제 인간의 의도와 상황을 제대로 이해하고 있는지, 추천과 판단이 인간에게 실제로 도움이 되는지를 Real Human Data와 비교해 검증할 수 있다.
셋째는 UX/CX Innovation이다.
로그에서는 발견하기 어려운 잠재 Needs와 Pain Point를 행동의 의미와 생활 맥락 속에서 발견함으로써 새로운 UX Opportunity를 찾을 수 있다.
넷째는 Personalization이다.
과거 행동 이력을 기반으로 한 추천에서 나아가 사용자의 현재 상황과 의도까지 고려하는 Context-aware Experience를 구현하는 기반이 될 수 있다.
결국 Human Data는 앞으로 단순한 Research Data를 넘어 AI를 학습시키고 평가하는 AI Learning & Validation Infrastructure로 역할이 확장될 가능성이 있다.
AI가 발전할수록 ‘Real’은 더 중요해질 수 있다
생성형 AI는 앞으로 더 많은 데이터를 만들어낼 것이다. Synthetic Consumer도 인간처럼 답변하고, 가상의 Persona도 인터뷰에 응할 수 있으며, AI Agent끼리 서비스 경험을 Simulation하는 것도 가능해질 것이다.
그렇다면 역설적으로 실제 인간에게서 발생한 데이터의 가치가 더 커질 수도 있다.
AI가 생성한 인간과 비슷한 데이터가 많아질수록 우리는 다시 물어야 한다.
“실제 사람은 어떻게 행동하는가?”
“실제 생활에서는 어떤 일이 벌어지는가?”
“AI가 이해한 인간과 진짜 인간 사이에는 어떤 차이가 있는가?”
이때 Real Human Data는 AI의 반대편에 있는 데이터가 아니라, AI가 인간에게 가까워지기 위해 끊임없이 참조해야 하는 Ground Truth가 될 수 있다.
1편의 첫머리에서 소개한 NVIDIA의 합성 페르소나가 중요한 것도 바로 이 때문이다.
가상의 인간을 더 정교하고 더 많이 만들어낼 수 있게 될수록, 그것이 실제 인간을 얼마나 잘 반영하고 있는지를 확인할 기준 역시 필요하다. 합성 데이터의 발전과 Real Human Data의 중요성은 서로 반대되는 흐름이 아니라 서로를 필요로 하는 흐름일 수 있다.
이 질문은 3편에서 다시 다루게 된다.
화면 밖의 것을 보는 데이터
앞으로 UX Research의 중요한 변화 중 하나는 어쩌면 ‘화면 안’에서 ‘화면 밖’으로 시선을 확장하는 것일지도 모른다. 화면에서 사용자가 어디를 클릭했는지만 보는 것이 아니라 그 순간 왜 망설였는지, 누구와 함께 있었는지, 어떤 공간에서 어떤 기기를 함께 사용하고 있었는지까지 보는 것이다. TV 화면을 연구하면서 TV 주변의 거실을 발견했던 것처럼 말이다.
인간을 이해하려면 행동만 보아서는 충분하지 않다. 행동의 의미를 보고, 행동이 발생한 삶의 맥락을 함께 봐야 한다. AI 시대의 데이터가 더 많아지는 것만큼 중요한 것은 더 인간적인 데이터가 많아지는 것일 수 있다.
그것이 최승환 상무가 생각하는 Real Human Data의 출발점이다.
여기서 다음 질문이 시작된다.
사람의 행동을 훨씬 더 많이 관찰하고 분석할 수 있게 됐을 때, AI는 사용자 자신도 아직 문제라고 생각하지 않는 행동 속에서 새로운 니즈를 발견할 수 있을까?
2편에서는 「AI는 우리가 보지 못했던 사용자를 발견할 수 있을까」를 살펴본다.
정리 : 한국디자인진흥원 서비스안전 디자인실
주석
[1] NVIDIA, Nemotron Personas (ko_KR), NVIDIA NGC, 2026. 데이터셋은 한국의 실제 인구통계·지리·성격 특성 분포를 기반으로 합성되었으며, NGC의 Dataset Quantification에는 100만 레코드, 총 700만 개의 페르소나 설명으로 제시되어 있다. 다만 같은 페이지의 Dataset Details에는 1,000만 personas라고 표기되어 있어 수량 표기가 일관되지는 않는다.
[2] 최승환, UXCX Data Needs Discovery 발표자료 및 한국디자인진흥원 발표·질의응답, 2026.9.16.
[3] 한국디자인진흥원, 「기다림을 디자인할 수 있을까? — 산업단지정책해커톤 퍼실리테이터 최승환」, 2026.5.11. 2026년 4월 17~18일 열린 산업단지 정책 해커톤에서 ‘붕어빵’ 팀의 ‘온통(On-通)이음 정류장’이 최우수상인 산업통상부장관상을 수상했다.
[4] 최승환, 한국디자인진흥원 발표, 2026.9.16. 마크로밀엠브레인은 약 180만 명의 소비자 패널을 운영하며, 이 가운데 약 2만 명을 영수증 패널로 운영한다고 설명했다.
[5] 최승환, UXCX Data Needs Discovery 미팅 및 발표, 2026.9.3·9.16. 영수증 데이터를 통해 제품별 구매량뿐 아니라 구매자의 연령대와 유통채널, 경쟁제품 구매행동 등을 분석하는 사례를 소개했다.
[6] 최승환, 한국디자인진흥원 발표, 2026.9.16. 스마트폰 홈화면 파일럿은 20명을 대상으로 진행했으며, 발표에서는 향후 더 큰 표본으로 확장할 수 있는 R&D 단계의 사례라고 설명했다.
[7] 같은 발표. ‘Circle to Search’ 실제 사용과 설정 과정을 화면 녹화로 수집해 조작 흐름과 시행착오를 분석한 사례.
[8] 최승환, UXCX Data Needs Discovery 미팅, 2026.9.3. Response Data → Behavior Data → Real Human Data의 변화와 함께 Real Human Data의 핵심을 행동의 의도·상황·만족도 등 ‘맥락정보’라고 설명했다.
-----
사용자를 읽는 방법이 바뀌고 있다 — 데이터와 AI로 확장되는 UX 리서치
최승환 마크로밀엠브레인 상무이사
1편 사용자에게 묻는 시대에서, 행동을 읽는 시대로 - 설문과 인터뷰를 넘어 구매기록, 화면, 영상에서 실제 사용자를 이해하는 방법
2편 AI는 우리가 보지 못했던 사용자를 발견할 수 있을까 - 행동과 인식의 차이에서 잠재 니즈를 찾아내는 새로운 사용자조사
3편 AI는 사용자를 대신할 수 있을까 - 합성 소비자의 가능성과 한계, 그리고 AI로 발견하고 사람으로 검증하는 리서치
발표자료


